A1 发现母体——从被清算的能力里,认出那个生成你的结构
A1 · 发现母体
从被清算的能力里,认出那个生成你的结构。
周日晚上十一点,一位技术行业的中层管理者把自己十年的简历粘进了 AI 对话框。年底述职在即,他本想让 AI 帮忙润色,鬼使神差地多问了一句:如果由你来做我的岗位,这份简历里哪些事是你做不了的?
回答几乎是即时的。AI 逐条过了一遍:方案撰写,可以;跨部门协调的邮件与话术,可以;技术选型的对比分析,可以;季度复盘报告,可以。最后一行写着:说实话,这份简历里的每一项,我都能做。
他不服气,追问:那我还剩什么?这一次 AI 温和而空洞:您的经验、热情与独特视角。他盯着屏幕坐了很久。让他发凉的不是第一个回答,能力被清算,他早有预感;让他发凉的是第二个回答的下面那层空——连 AI 都说不出他还剩什么,因为他自己从来没有向任何人、包括向自己,提交过这个问题的证据。
请先记住这一句,本关最后要回到它:他从没为「还剩什么」交过证据。
他从没为「还剩什么」交过证据。
发现母体,就是替他补交这份证据。而在补交之前,得先把五层最容易被当成母体的东西,一层层剥掉。
它不是找一个兴趣爱好。兴趣回答「我喜欢消费什么」,母体回答「我会持续生产什么」,你可以对二十件事保持兴趣,可让你十年绕不开、不做就难受的那个问题,通常只有一个。它也不是测出一个人格标签。标签是把你归入某个人群的分类学,母体是把你和所有人区分开的生成学,测评能告诉你属于哪一型,说不出你为什么偏偏对那个问题较劲。它更不是盘点一份职业优势清单。优势清单列的是产出物,母体是那条看不见的生产线,产出物会过时、会被复制,生产线还在源源不断地造新的。它同样不是等一次灵感或顿悟。灵感只是母体偶尔的闪光,母体是闪光背后从不断电的那台机器,指望顿悟找母体,等于站在岸边数浪花来推测洋流。
还有第五重误认,专门捕获聪明人:把「差异化定位」当成母体。他们方向全对,知道要找差异、要避开同质化,于是从市场倒推,给自己设计出一个精心校准的独特人设。可设计出来的差异需要意志力维持,生成出来的差异关都关不掉。方向对了,来路错了:母体不是你为市场设计的答案,是市场还不存在时就在生成你的那个结构。
稀缺,被每一轮技术推向源头
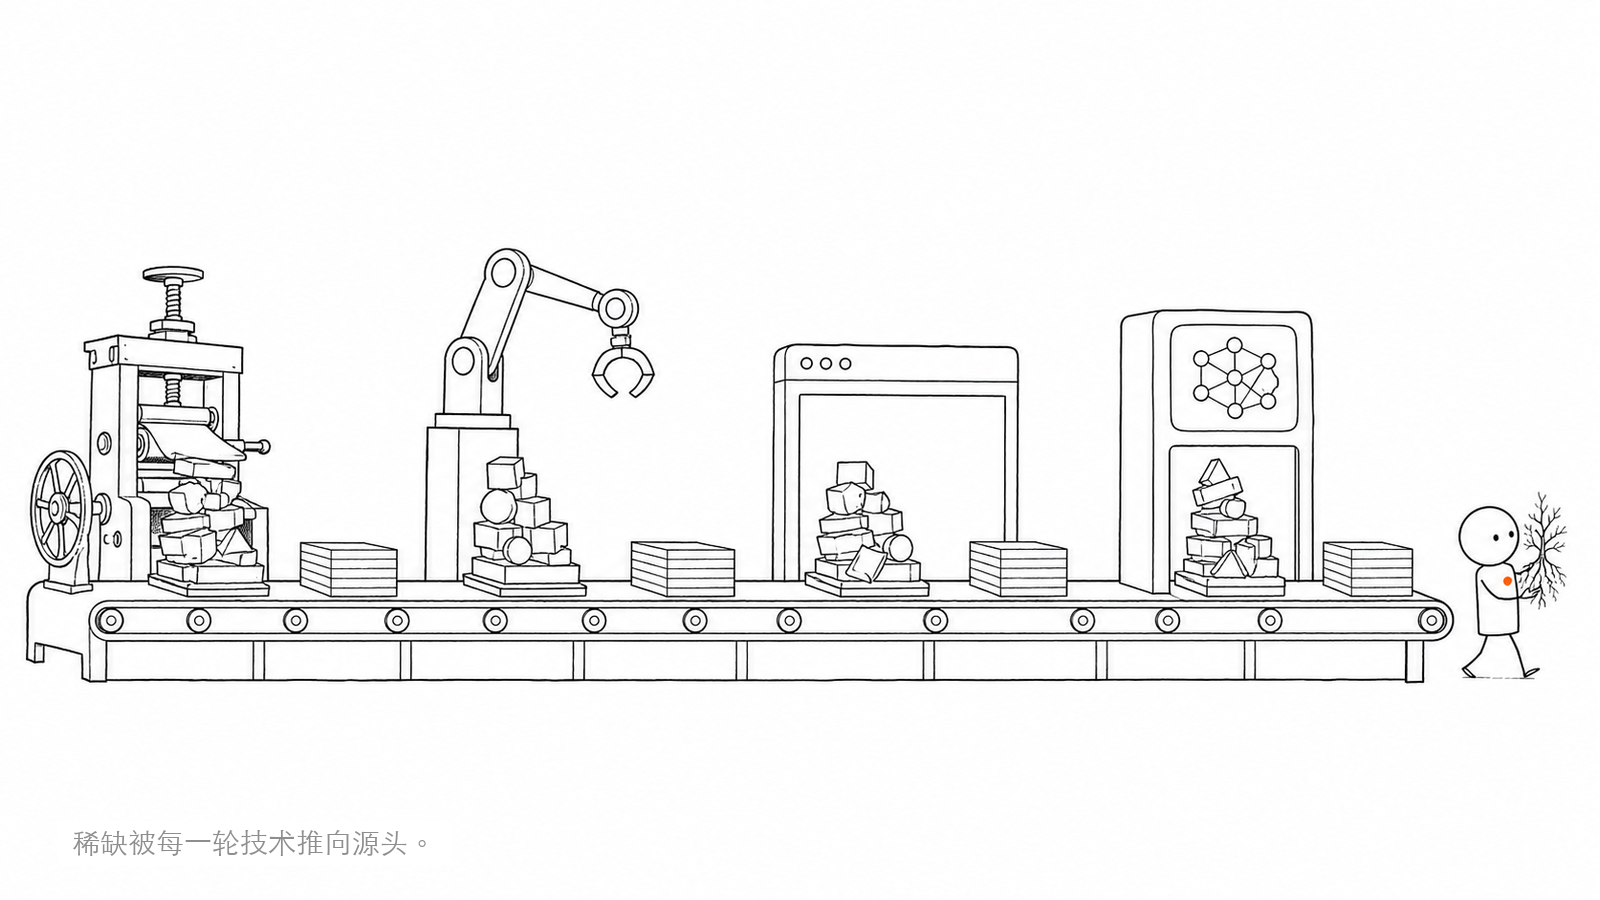
稀缺被每一轮技术推向源头。
能力被平权不是 AI 的发明,是技术史的固定节目。这件事,历史上真金白银演过好几遍,有年份、有账、有名有姓的人从此丢了饭碗。把它们摆到一条时间轴上,那位盯着屏幕的管理者才知道,他撞见的不是一次新鲜事故,是一台运转了近六百年的机器,这次刚好轧到他这一代。
| 浪潮 | 时间 | 被平权的能力 | 稀缺退到哪一格 | 那一刀落在谁身上 |
|---|---|---|---|---|
| 印刷术 | 约 1455 年《古腾堡圣经》问世 | 抄写、识字、复制文本 | 原创与判断 | 抄经僧 |
| 流水线 | 1913 年福特移动装配线 | 熟练工匠的整体技艺 | 设计与组织 | 老师傅 |
| 互联网 | 约 1990s–2000s | 信息获取、出版、检索 | 信息的筛选与审美 | 出版社、电视台的守门人 |
| AI | 2022 年 11 月 ChatGPT 发布 | 可描述的认知执行(写、编、设、析) | 生成差异的结构本身 | 会写会算会分析的白领 |
古腾堡之前,「识字并亲手复制一本书」是抄经僧一辈子的稀缺技能;约 1455 年那本四十二行《圣经》成书之后,同一件事变成一台机器几个昼夜的活。稀缺没有消失,它只是从「会不会抄」退到了「抄什么、为什么抄」——退到了原创与判断那一格。
1913 年,福特在高地公园厂拉起世界第一条汽车移动装配线,把一辆 Model T 的装配时间从 728 分钟压到 93 分钟。被压缩掉的不是七个多小时,是老师傅几十年攒下的整体手艺这道护城河,它被拆成了谁培训几天都能上手的单个工位。老师傅那句「这活得我来」,从此不再值钱。稀缺又退了一格,退到设计与组织。
互联网这一轮更隐蔽。万维网在 1990 到 1991 年间问世,浏览器把「出版」平权给了任何有一张网页的人,搜索引擎把「检索信息」平权给了任何会打字的人。出版社、电视台那批决定什么能被看见的守门人,护城河被抽干了。稀缺退到信息的筛选与审美——会找、会挑、有品位,比会存更值钱。
前三轮有个共同的仁慈:人总能往下退一级技能里避难。抄写没了退到判断,手艺没了退到设计,信息通道没了退到审美。可这台机器每转一圈,留给人躲的格子就少一个。轮到 AI 这一轮,它不再平权某一类具体技能,它平权的是「可描述的认知执行」这整个类别——写、编、设、析,凡是能说清楚步骤的,它都能接。
退无可退。
稀缺被推到了最后一格:不再是你会做什么,而是你身上那个持续生成判断的结构。退无可退,却也终于退到了真东西上。
AI 平权的不是某一类技能,是「技能」这个类别本身。你囤的每一项新技能,都是在给一台跑了六百年的清算机器送料——它清算不掉的从来不是某项本事,是那个决定你去学这项、不学那项的你。
这句话之所以要紧,是因为大多数人对 AI 的第一反应,恰恰是反着来的:AI 来了,我得赶紧学更稀缺、AI 学不会的技能,才不被淘汰。这反应太自然了,自然到没人停下来看它错在哪。它错在,「该学什么技能」这个问题本身,就把你摆进了那个正在被轧的格子——你越是勤奋地囤新技能,越是在把自己往清算机的入口送料,那不是自救,是把死亡分期偿还。真正的自救,第一步压根不是学什么,是认出那个造技能、却永远不站在被轧格子里的结构。
那这套判断怎样才算错?很简单:如果你能找到一个人,纯靠不断学新的、可描述的技能,说不清自己的母体是什么,却在这一轮持续拉开差距、拉了整整十年——那这套说法就得推倒重写。它跟成功学的分界就在这里:成功学不敢给自己设一个能被证伪的靶子,这套敢。
而这一轮,不是坐在岸边等它慢慢来。2023 年 OpenAI 和宾夕法尼亚大学联手发过一篇叫《GPTs are GPTs》的论文,把大模型对就业的暴露面做了实测:约 80% 的美国劳动力,至少有 10% 的工作任务会被大模型改写;约 19% 的人,一半以上的任务会被改写;若把基于大模型的软件工具一并算进去,全美约 47% 到 56% 的工作任务可以被显著加速。这不是谁的预言,是一份带方法、带样本、放在 arXiv 上任人核对的口径。那位管理者盯着「每一项我都能做」发凉,只是把这份宏观账,在一份简历上验了一遍。
更该让人坐直的是速度。ChatGPT 在 2022 年 11 月底免费开放后,约两个月就摸到一亿月活,被追踪互联网二十年的分析师称为增长最快的消费级应用——同一道「破亿」的坎,节奏最接近的 TikTok 也走了约九个月。平权本身的节奏在指数级坍缩:前几轮,一个手艺人还来得及用大半辈子的时间去适应、去转行;这一轮,留给你重新认出自己的窗口,是以月计的。
清算听起来是坏消息,对发现母体却是天赐的显影液。它做的事,是把一份混着「我会什么」和「我是什么」的简历,替你拆成了两栏:可复制的那些批量归零,剩下的自动凸显。潮水退得越狠,礁石的轮廓越完整。所以发现母体的最佳时机不在清算之前,恰恰在清算最猛烈的此刻。
母体不接受自我申报,只接受证据
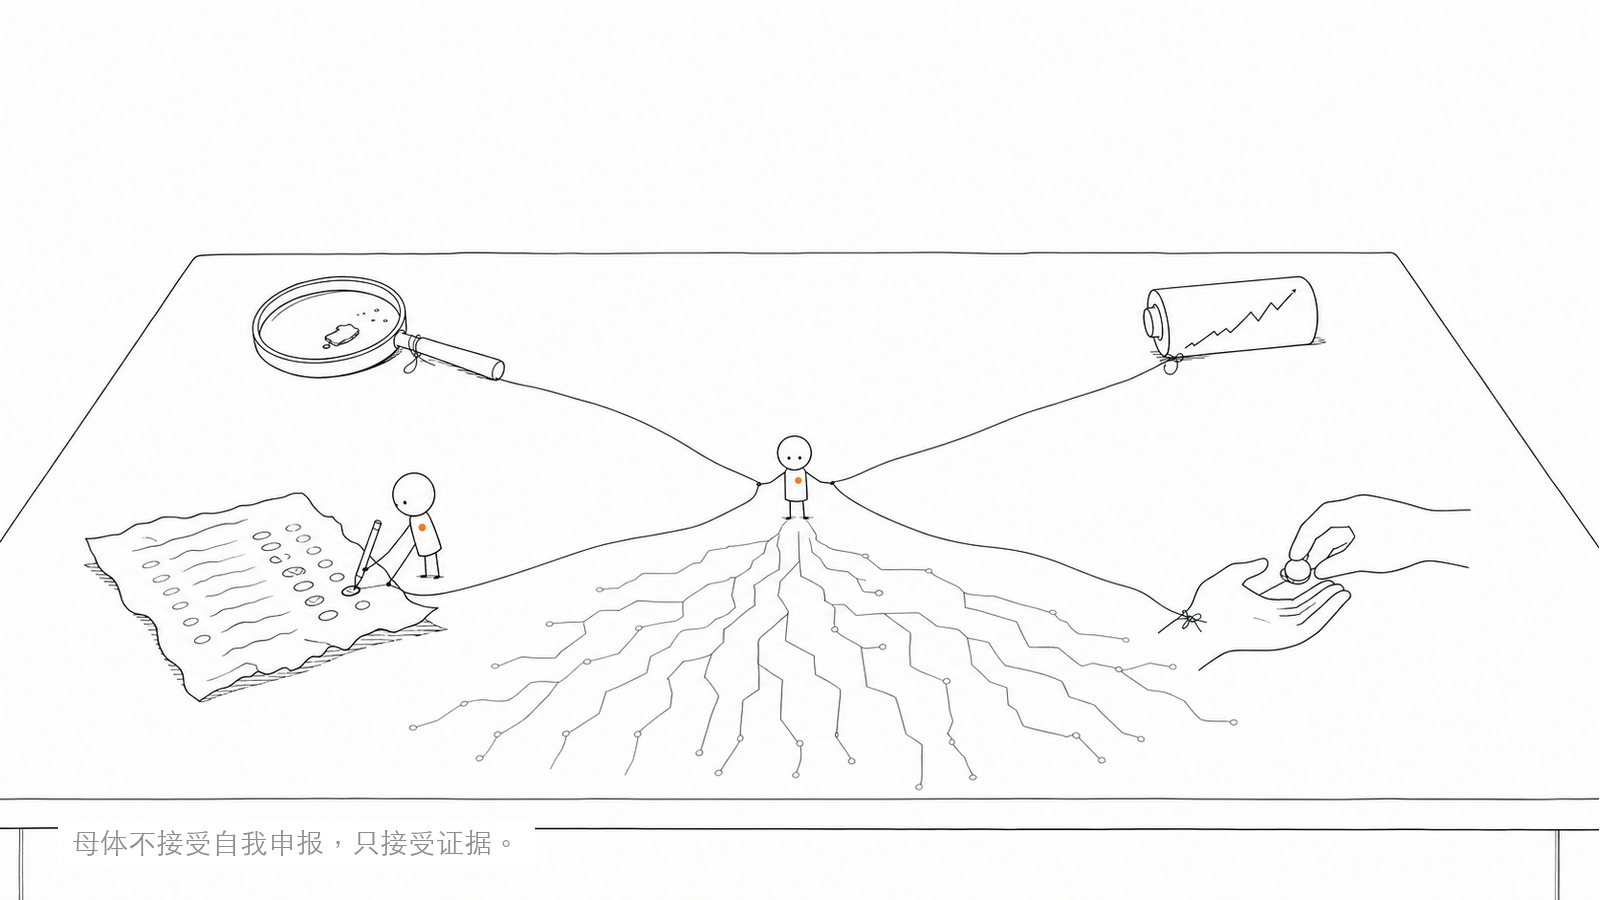
母体不接受自我申报,只接受证据。
母体没法直接看,它是结构,不是物件。你能看到的只有它投在生活里的影子,所以发现母体走的是一条取证链:从异常注意、高能事件、低级答案厌恶、别人反复的获得物这些行为残迹里,反推那个不可直接观测的底层结构。
这条链的方向是关键。不是先想清楚「我是谁」再去找证据,而是先摊开证据,再让母题自己浮现。母体不接受自我申报,只接受证据。
顺着这条方向,正典给了发现母体一句话定义:
发现母体,是从同质化能力、外部标签和二手共识中,识别出自己持续生成判断、作品、关系和意义的底层生命结构。
它要回答的第一性问题只有一句:
AI 清算所有同质化能力之后,我身上还剩什么会持续生成差异?
六个原子模块:一条取证顺序
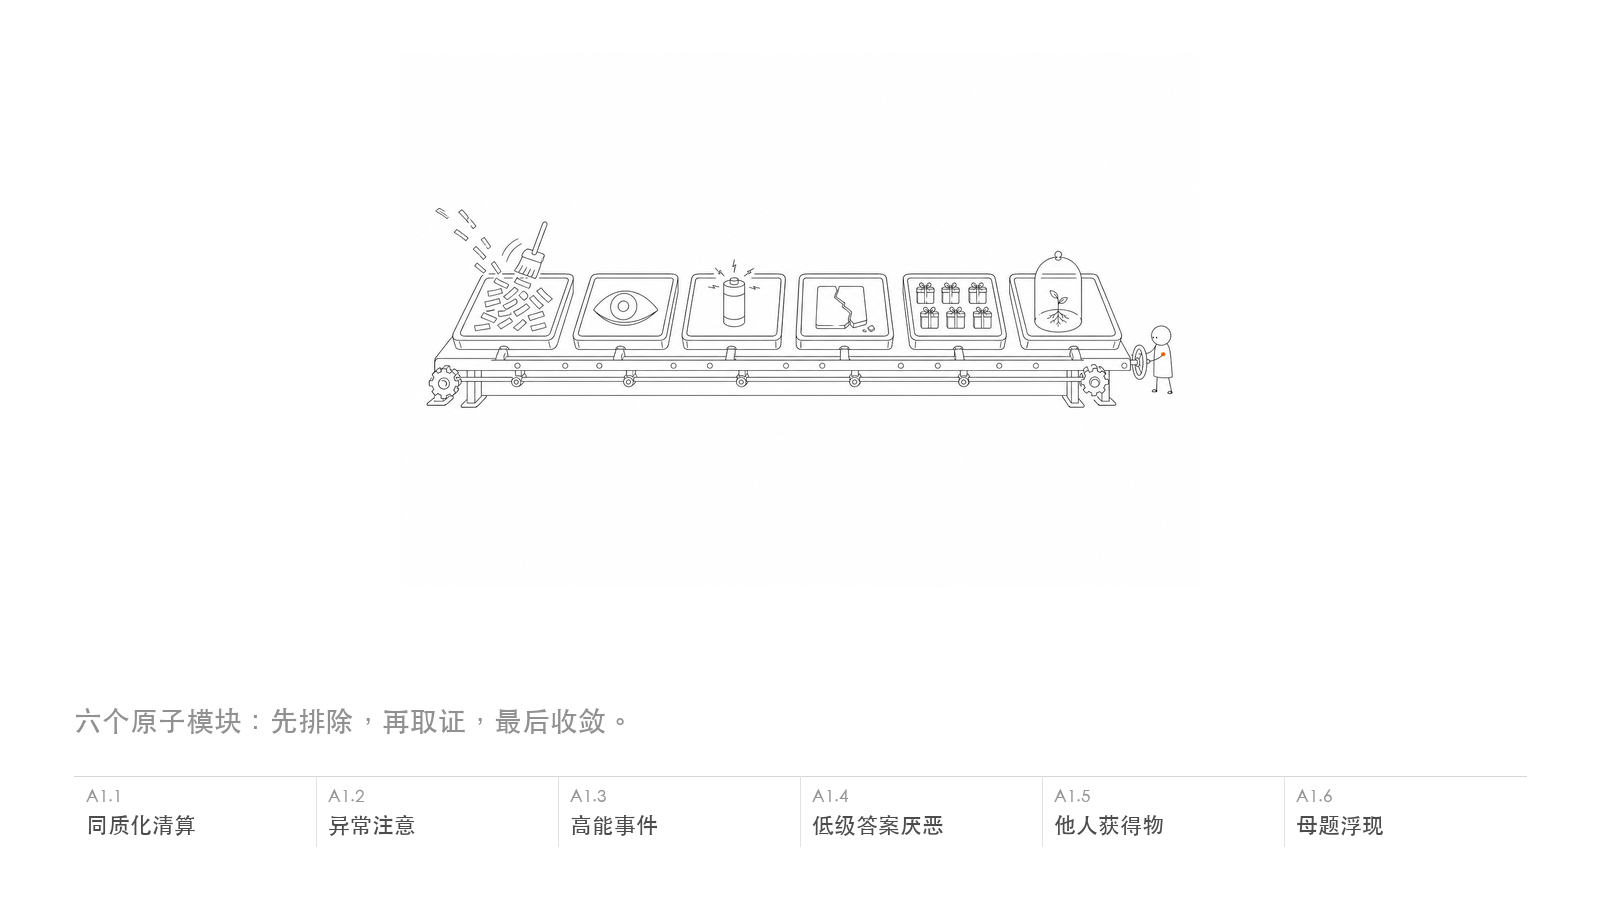
先做排除,再从四路信号取证,最后让母题浮现。
把这个问题拆到可操作的层面,它由六个原子模块构成,正典原文如下:
| ID | 模块 | 正典原文 |
|---|---|---|
| A1.1 | 同质化清算 | 哪些能力正在被 AI 平权、复制、自动化。 |
| A1.2 | 异常注意 | 我天然会注意什么,别人看不见什么。 |
| A1.3 | 高能事件 | 什么事情让我越做越清楚、越做越有能量。 |
| A1.4 | 低级答案厌恶 | 我最无法忍受哪些粗糙、伪高级或错误答案。 |
| A1.5 | 他人获得物 | 别人反复从我这里获得什么。 |
| A1.6 | 母题浮现 | 这些现象背后共同指向的主问题是什么。 |
这六个不是并列的清单,是一条取证顺序:先做排除(A1.1),再从四路信号取证(A1.2 到 A1.5),最后收敛(A1.6)——把前五步的证据摊在一张桌上,问它们究竟在共同回答哪一个问题。其中 A1.3 藏着一个来自天才区研究的硬判据:做完一件事,你的能量是回流还是耗尽。卓越区里你做得漂亮,但事后要回血;天才区里你越做越有电。这一条常常比任何自我描述都诚实。
要喂进这台取证机的,是这样一批原料:过去三年的高能事件与低能事件、别人反复找你解决的问题、你长期关注的主题、你最不能忍受的低级答案,以及 AI 已经可以替代的那份工作清单。
五道判断标准:候选是不是真母体
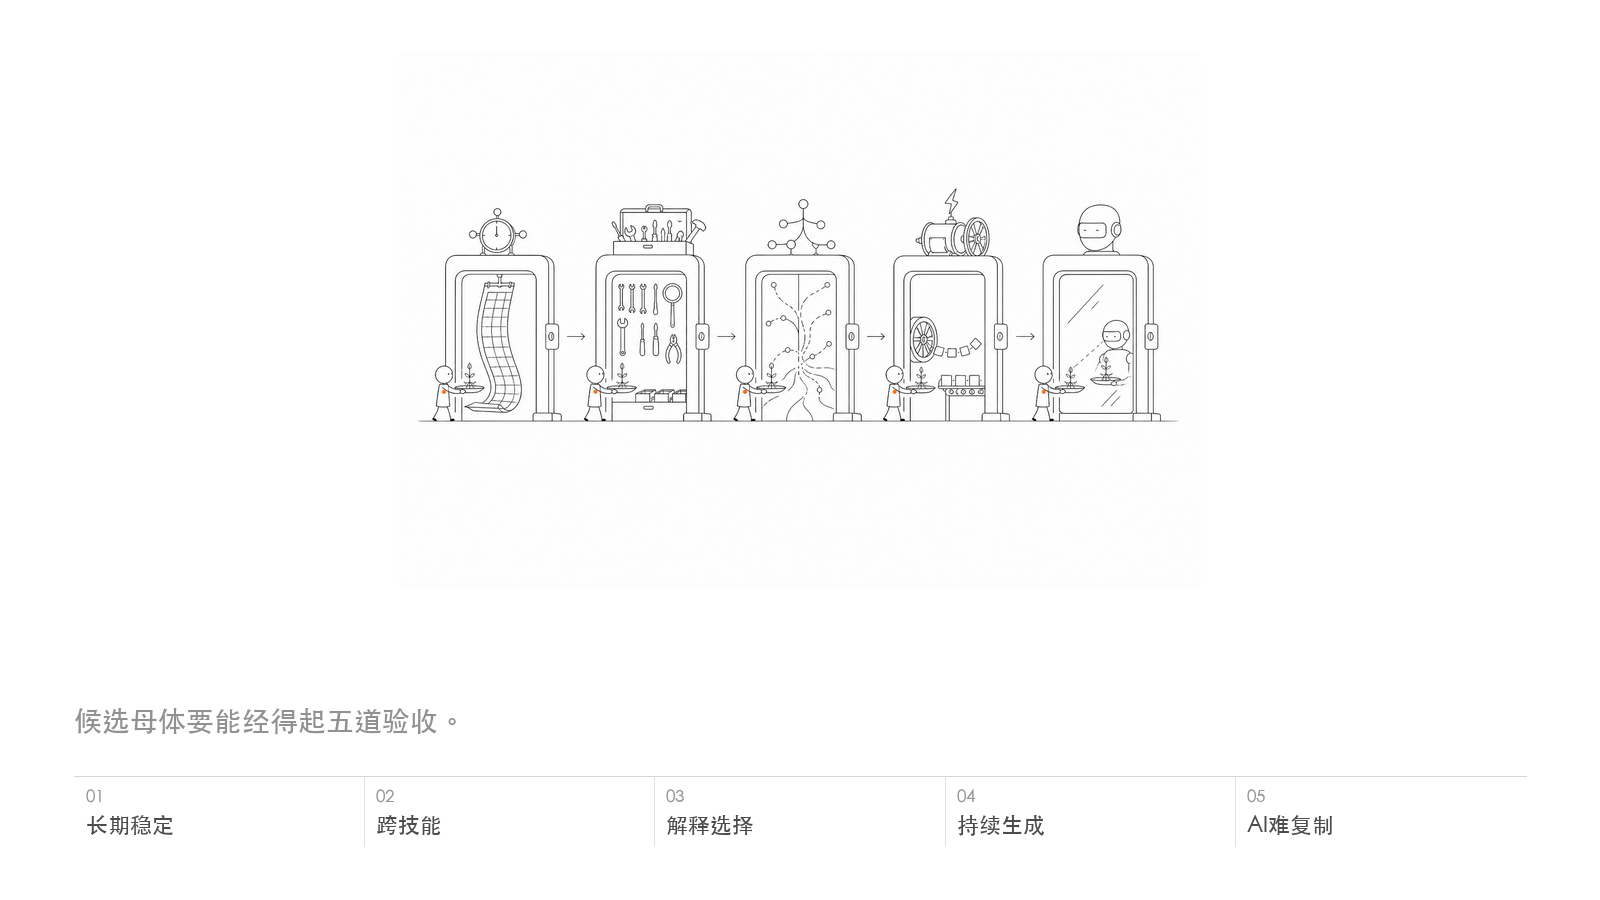
候选母体要能经得起五道验收。
摊完证据、浮出母题,还要过一道验收。一个候选够不够格叫母体,正典给了五条标准:
| # | 判断标准 |
|---|---|
| 1 | 它是否长期稳定? |
| 2 | 它是否不依赖单一技能? |
| 3 | 它是否解释了我过去多个选择? |
| 4 | 它是否持续生成判断、作品、关系或意义? |
| 5 | 它是否是 AI 难以直接复制的生命结构? |
五条都过,你就得到本关的产出:原力母体候选、母题清单、同质化能力清单,以及一句话的母体假设。这个假设还得能过复述测试——第二天你能不查笔记,把自己的母体一句话讲给别人听,它才算真的立住了。
母体也会往回长
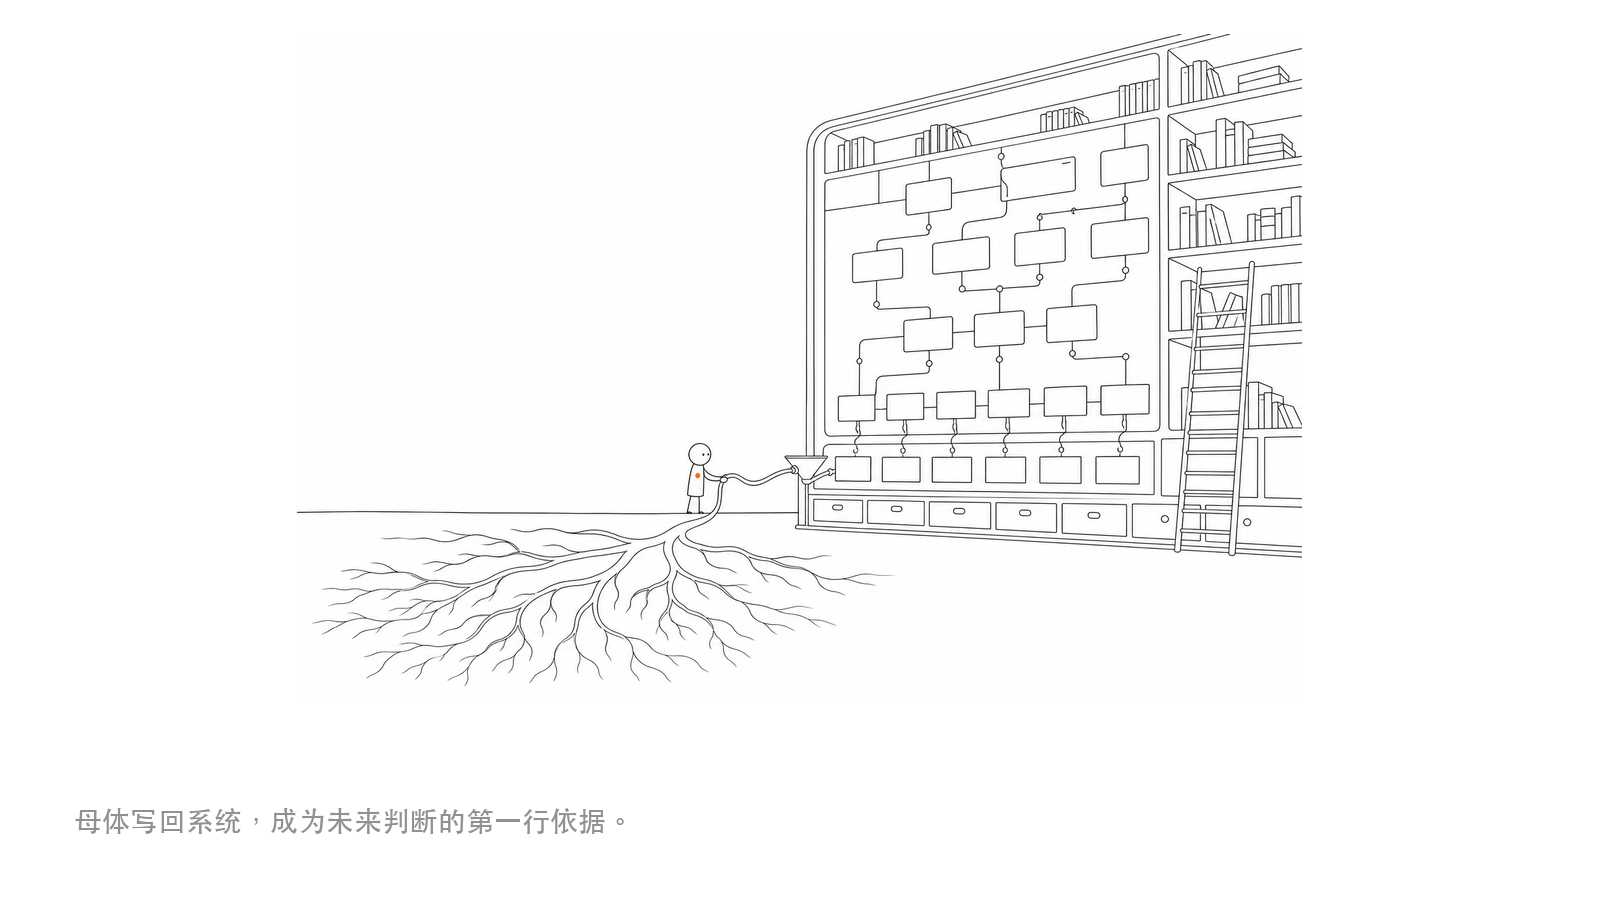
母体写回系统,成为未来判断的第一行依据。
A1 的输出不是一篇读后感,是要写进系统的资产。母体一句话假设与母题清单,写入原力母体总卡与 OS 文脉(C1),它将成为 AI 判断「像我 / 不像我」的第一行依据;长期主题库写入大脑(C2),成为后续一切检索与外化的种子。而 A1 的候选终究只是假设,还要交给 A2 用五部件检验成形。全库的回写关系,见十二模块递归回写图。
想知道自己这一关到底过没过,停下来诚实答三个问题就够了。第一,你能不能用一句话说出「AI 清算不掉的那个你」?第二,这句话能不能解释你过去至少三个重大选择?第三,过去一年别人反复从你这里获得的东西,是不是和这句话指向一致?三个都答「是」,你的母体候选已立,进 A2·回到母体;任何一问答「否」,你还卡在本关,回到六个取证模块重新摊证据,别急着往下走。更完整的分诊,在你卡在哪一关。
A1 背后其实压着一条更长的修行链——觉察、高能、阴影、整合、资产、复利六阶,三十节课的矿脉都埋在里面。最值得往下钻的是「高能」与「阴影」两阶:为什么你最讨厌自己的那个缺点,恰恰是母体信号最强的地方?这条线在深潜·六阶通关链里全量展开。
母公理ʸx 说,做会自我繁殖的事。可在你身上,有一样东西早就在这么做了:它在你十几岁反复翻开的那类书里,在你忍不住多问的那一句里,在你明知不划算还是做了的那些事里,一遍一遍生成着判断、作品、关系和意义。你不是要从零建一个会繁殖的东西,你是要认出那个一直在繁殖你的东西。清算是时代的事,认出是你的事。
回到开篇那位管理者。他之所以发凉,不是因为 AI 太强,是因为他这辈子从没为「还剩什么」交过一次证据——现在这台六百年的清算机器把他所有可描述的本事一格格轧平,反倒逼他第一次去补交。设计出来的差异需要维持,生成出来的差异关不掉。
你不是缺一项更稀缺的技能,你是站错了格子。
而发现母体那一刻,通常没有烟花,只有一声很轻的:哦,原来一直是它。
源与置信度:A1 定义、第一性问题、原子模块表、判断标准表、输入输出,照录 04d 正典,🟢;能量回流判据源自天才区概念(wiki),🟢;平权浪潮真年表的历史年份——古腾堡《圣经》约 1455 年成书(学界锁 1454–1455 区间,民间传说的「2 月 23 日」不作定论)、福特 1913 年移动装配线、装配时间 728→93 分钟(福特官方常引口径)、万维网 1990–1991 年问世、ChatGPT 2022 年 11 月发布,均🟢;《GPTs are GPTs》劳动力暴露面(约 80% 劳动力≥10% 任务、约 19% 劳动者≥50% 任务、计入工具 47%–56% 任务可显著加速,OpenAI×宾大,arXiv:2303.10130,2023)🟢;ChatGPT 约两个月破一亿月活、对照 TikTok 约 9 个月,UBS 口径多源一致,🟢;各技术「达普及所需年数」的绝对值因门槛定义不一,趋势🟢、绝对数字🟡,正文只取趋势未引具体年数;「AI 是首次认知平权」「被平权的是护城河不是工具」为叙事判断、可证伪,🟡;稀缺退守表与清算前后描述为本篇结构化推演,🟡;切口人物为「行业+角色」式脱敏合成,🟡。